
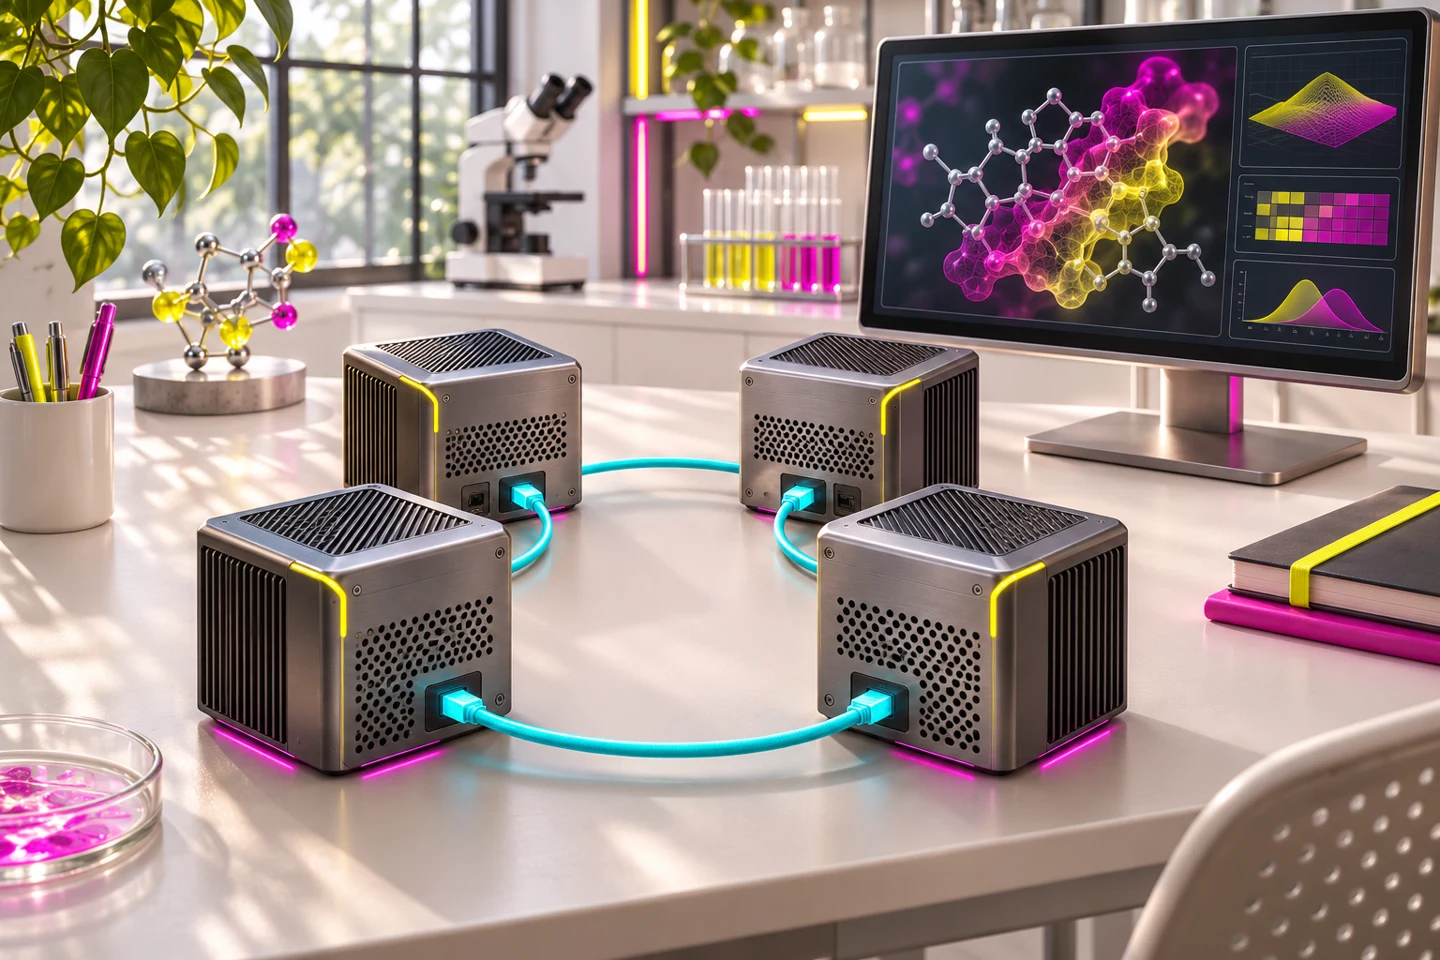
Що означають чотири вузли на столі
Кожна система використовує GB10 Grace Blackwell. Вузли безпосередньо з’єднані із сусідами, що прибирає потребу купувати й налаштовувати зовнішній комутатор для описаної схеми. Сумарні 512 ГБ не слід автоматично трактувати як одну локальну пам’ять одного GPU: застосунок має розподіляти модель і обмінюватися даними між системами. NVIDIA заявляє можливість запуску моделей до 700 мільярдів параметрів із NVFP4 у чотиривузловій конфігурації. Це твердження про місткість за певної точності, а не обіцянка довільного контексту чи однакової швидкості для всіх моделей.
Науковий код і локальні моделі мають різні потреби
Серед продемонстрованих чотирисистемних навантажень компанія називає LAMMPS із Kokkos та NAMD. Окремо вона наводить перевірені спільнотою сценарії GROMACS, OpenFOAM і WRF. Не всі перелічені приклади є одним стандартизованим бенчмарком набору. Для дослідника цінність локального кластера може полягати у перевірці розподілу даних, налагодженні комунікації та підготовці симуляції до запуску на більшій машині. Це інший критерій, ніж максимальна кількість токенів за секунду під час інференсу чат-моделі.
LoRA і строки очікування треба оцінювати окремо
В анонсі описано використання одного DGX Spark групою Hartwig у Berkeley для LoRA-донавчання Nemotron 3 Super 120B-A12B у хімічному машинному навчанні з NVFP4. Компанія також наводить дослідницькі випадки, де локальна робота обходила багатогодинну або багатоденну чергу на спільному кластері. Швидше отримати результат без черги не означає, що сам обчислювальний kernel прискорився в стільки ж разів. Застосовність такого прикладу залежить від адаптера, моделі, квантизації та задачі; переносити його на будь-яке повне тренування великої моделі некоректно.
Що доступне зараз, а що обіцяють пізніше
NVIDIA повідомляє, що набір показують на SC26 і його можна придбати, а системи й кабелі пропонують OEM-партнери та NVIDIA Marketplace. Водночас спеціальний installation playbook для NVIDIA HPC SDK ще готується. Майбутній посібник має охопити прискорені компілятори C, C++ і Fortran, бібліотеки та MPI-інструменти. Команда, яка планує власний локальний стенд, має розділяти наявність обладнання та готовність конкретної інструкції розгортання. Перед перенесенням задачі важливі сумісність коду, топологія обміну, числова точність і вимірювання саме свого навантаження.
Обговорення.
Твій погляд має значення. Увійди, обери нікнейм та свій кіберобраз.
Завантажуємо обговорення…
Ім’я, email і фото з акаунта не публікуємо.